У попередній статті ми навчилися знаходити типовий результат досліджуваної групи.
Припустимо, середній рівень тривожності студентів становив 42 бали.
Але чи означає це, що всі студенти мають приблизно однаковий рівень тривожності?
Зовсім ні.
В одній групі майже всі учасники можуть набрати від 40 до 44 балів. В іншій — половина матиме 20 балів, а інша половина — 64. І хоча середнє в обох випадках буде однаковим, це будуть дві абсолютно різні групи людей. Саме тому психологу недостатньо знати лише середнє значення. Потрібно ще зрозуміти, наскільки результати відрізняються один від одного.
Для цього використовують міри мінливості.
Яке дослідницьке питання допомагають розв'язати?
Чи можу я описати всю групу одним середнім значенням?
Це геніально просте питання. Бо саме його дослідник фактично вирішує.
Якщо мінливість невелика — так, середній показник досить добре описує більшість учасників.
Якщо мінливість велика — ні, середнє вже приховує суттєві відмінності між людьми.
Знаючи лише середній результат, ми ще дуже мало знаємо про досліджувану групу. Значно важливіше зрозуміти, наскільки її представники схожі між собою.
Саме тому після визначення центральної тенденції виникають нові дослідницькі запитання:
- Наскільки результати учасників відрізняються один від одного?
- Чи є досліджувана група однорідною, чи до її складу входять люди з дуже різними характеристиками?
- Чи можна вважати середній показник справді типовим для більшості учасників?
- Чи є серед досліджуваних люди з дуже високими або дуже низькими результатами?
Саме на ці запитання відповідають міри мінливості.
Вони показують не де знаходиться центр вибірки, а наскільки далеко результати окремих учасників можуть відхилятися від цього центру.
Навіщо це психологу?
Самі по собі міри мінливості рідко є кінцевим результатом дослідження. Їх головна цінність полягає в тому, що вони допомагають психологу приймати правильні дослідницькі рішення.
Якщо міри центральної тенденції нам допомагають описати типового представника групи, то міри мінливості да відповідь на запитання: "Чи існує взагалі "типовий представник" цієї групи?"
Наприклад.
Якщо стандартне відхилення маленьке — так, можна говорити про типового представника.
Якщо воно величезне — ні. Група настільки різнорідна, що образ "типового студента" чи "типового волонтера" просто втрачає сенс.
Мінімальне та максимальне (Xmin; Xmax)
Що показують?
Мінімальне та максимальне значення визначають межі, в яких знаходяться результати досліджуваної вибірки. Вони дозволяють швидко оцінити, наскільки широким є діапазон отриманих результатів. Самі по собі ці показники не характеризують ані типовий результат, ані ступінь мінливості. Проте вони дають перше уявлення про межі вибірки та допомагають помітити незвично високі або низькі значення.
Мінімальне (Xmin) — це найменше значення вимірювання (змінної) у вибірці.
Максимальне (Xmax) — це найбільше значення вимірювання (змінної) у вибірці.
Тобто, ці заходи не дуже інформативні. Особливо якщо величина розподіляється за нормальним законом. Але якщо ми вимірюємо якусь конкретну властивість на прикладі вузької вибірки (наприклад, агресивність людей, які страждають на якійсь психічний розлад чи соматичне захворювання), то мінімальне і максимальне значення можуть дати можливість якісно описати цю вибірку і краще розуміти особливості її представників.
Коли використовують?
Мінімальне та максимальне значення доцільно аналізувати:
- під час первинного опису вибірки;
- для оцінки можливих викидів або помилок введення даних;
- для характеристики меж прояву психологічної властивості у досліджуваній групі.
Переваги
- дуже прості для розуміння;
- швидко дають уявлення про межі результатів;
- допомагають перевірити коректність даних.
Обмеження
Мінімум і максимум залежать лише від двох спостережень — найменшого та найбільшого значення. Тому вони нічого не повідомляють про те, як розподілені решта результатів.
Приклад
Під час дослідження професійного вигорання психологів найнижчий результат становив 18 балів, а найвищий — 79 балів.
Це означає лише те, що саме в цих межах знаходяться результати вибірки. За цими показниками ще не можна зробити висновок, чи більшість психологів мають високий рівень вигорання або наскільки сильно вони відрізняються між собою.
Розмах (R)
Що показує?
Розмах показує, наскільки широкий діапазон отриманих результатів. Він обчислюється як різниця між найбільшим і найменшим значеннями вибірки. Іншими словами, розмах відповідає на запитання: Якою є максимальна відстань між найнижчим і найвищим результатом у досліджуваній групі?
Чим більший розмах, тим ширший діапазон значень отримано у вибірці. Проте це ще не означає, що всі результати рівномірно розподілені в цьому інтервалі.
Коли використовують?
Розмах доцільно використовувати:
- для швидкої оцінки загального діапазону результатів;
- під час первинного опису вибірки;
- для порівняння меж результатів у різних групах;
- як допоміжний показник перед використанням інших мір мінливості.
Переваги
- легко обчислюється та інтерпретується;
- швидко дає уявлення про ширину діапазону значень;
- дозволяє швидко порівняти межі результатів у різних вибірках.
Обмеження
Розмах враховує лише два значення — мінімальне і максимальне.
Тому він не показує:
- як розподілені результати всередині вибірки;
- чи більшість учасників мають схожі показники;
- чи широкий розмах зумовлений лише одним або двома крайніми значеннями.
Крім того, розмах дуже чутливий до викидів. Один незвично високий або низький результат може суттєво збільшити його величину.
Приклад.
Припустимо, що під час дослідження професійного вигорання психологів найнижчий результат становив 18 балів, а найвищий — 78 балів.
Отже, розмах дорівнює 60 балів.
Це означає, що у вибірці спостерігається досить широкий діапазон рівнів професійного вигорання. Проте за самим лише розмахом ще неможливо сказати, чи більшість психологів мають близькі результати, чи вони рівномірно розподілені між крайніми значеннями. Для цього необхідно використовувати інші міри мінливості, наприклад стандартне відхилення або міжквартильний розмах.
Як розраховується?
Розмах визначають як різницю між максимальним і мінімальним значеннями вибірки:
\( R = X_{max} - X_{min} \)
Приклад: припустимо у нас є вибірка значень {3,4,5,6,7} де максимальне значення 7, а мінімальне 3, отримаємо:
\( R = 7 - 3 = 4 \)
Мінімальне, максимальне і розмах вимірювань властивості у представників двох незалежних вибірок (наприклад, чоловіків та жінок), представлені у вигляді графіка, дозволяють візуально визначити наявність відмінностей в прояві досліджуваної властивості. А отже припустити вплив ознаки (в нашому прикладі це стать випробовуваних) на вираженість властивості.
Міжквартильний розмах (IQR)
Що показує?
Розмах дозволяє оцінити загальну ширину діапазону результатів, але він дуже чутливий до поодиноких дуже великих або дуже малих значень. Щоб оцінити мінливість більшості результатів, використовують міжквартильний розмах (Interquartile Range, IQR). Він показує, наскільки відрізняються між собою центральні 50 % результатів вибірки, тобто ті результати, які розташовані між першим (Q1) і третім (Q3) квартилями. Інакше кажучи, IQR характеризує розкид основної частини вибірки, практично не зважаючи на крайні значення.
Якщо розмах описує всю вибірку, то міжквартильний розмах описує її "ядро".
Коли використовують?
Міжквартильний розмах доцільно використовувати, коли:
- у вибірці є дуже високі або дуже низькі результати (викиди);
- розподіл є асиметричним;
- потрібно оцінити мінливість більшості учасників, а не всієї вибірки;
- використовують медіану як основну міру центральної тенденції.
Переваги
- майже не залежить від викидів;
- добре описує розкид основної частини вибірки;
- підходить для асиметричних розподілів;
- часто використовується разом із медіаною.
Обмеження
Міжквартильний розмах враховує лише центральні 50 % результатів.
Тому він:
- не показує повний діапазон значень;
- не відображає крайні результати;
- може приховувати важливу інформацію про дуже високі або дуже низькі показники.
Приклад.
Припустимо, під час дослідження рівня тривожності більшість студентів набрала від 38 до 46 балів, але декілька учасників мали дуже низькі (18–20 балів) або дуже високі (68–72 бали) результати. У такій ситуації розмах буде досить великим і може створити враження, що вся вибірка є дуже неоднорідною.
Натомість міжквартильний розмах покаже, що центральні 50 % студентів мають досить близькі результати, а значний розмах зумовлений лише невеликою кількістю крайніх значень. Саме тому IQR вважають більш стійкою характеристикою мінливості, ніж розмах.
Як розраховується?
Квартиль (Q) - це таке значення, що ділить відсортовані (ранжируванні) дані на частини, кратні одній чверті, або 25%, що відповідає 25-му процентлю або квантилю 0.25. Так, 1-й квартиль (Q1) - це значення, нижче якого знаходиться 25% вибірки. 2-й квартиль (Q2) ділить вибірку даних навпіл і дорівнює медіані, ну і 3-й квартиль (Q3) це значення вище якого знаходиться 25% максимальних значень. Так ось міжквартільний розмах - це різниця між 3-м і 1-м квартилями.
Для обчислення міжквартильного розмаху спочатку потрібно визначити перший (Q1) та третій (Q3) квартилі.
Для цього всі результати впорядковують за зростанням, після чого знаходять три значення:
- Q1 — значення, нижче якого знаходяться приблизно 25 % результатів;
- Q2 — медіана, яка ділить вибірку навпіл;
- Q3 — значення, нижче якого знаходяться приблизно 75 % результатів.
Після цього міжквартильний розмах обчислюють як різницю між третім і першим квартилями:
\( IQR = Q3 -Q1 \)
У цього показника є одна незаперечна перевага: він є робастним (тобто, стійким до викидів).
Приклад.
Припустимо у нас є вибірка відсортованих значень {1, 1, 1, 2, 2, 2, 3, 3, 3, 4, 4, 4, 5, 5, 5}.
Крок 1. Знаходимо медіану (Q2).
Оскільки у вибірці 15 спостережень, медіаною буде восьме значення: {1 1 1 2 2 2 3 |3| 3 4 4 4 5 5 5}.
Отже, Q2 = 3
Крок 2. Визначаємо перший квартиль (Q1).
Беремо нижню половину вибірки (без медіани): {1 1 1 2 2 2 3}
Медіана цього ряду: {1 1 1 |2| 2 2 3}
Отже, Q1 = 2
Крок 3. Визначаємо третій квартиль (Q3).
Беремо верхню половину вибірки: {3 4 4 4 5 5 5}
Медіана цього ряду: {3 4 4 |4| 5 5 5}
Отже, Q3 = 4
Тоді міжквартильний розмах дорівнює:
\( IQR = 4 - 2 = 2 \)
Важливо.
Під час визначення квартилів враховують усі спостереження, навіть якщо деякі значення повторюються багато разів. Квартилі визначаються не за кількістю різних значень, а за їхнім положенням у впорядкованому ряді.
У різних статистичних пакетах (SPSS, Jamovi, R, Excel тощо) можуть використовуватися дещо різні алгоритми обчислення квартилів, особливо для невеликих вибірок. Через це значення Q1, Q3 та IQR іноді можуть незначно відрізнятися. Проте принцип їх інтерпретації залишається однаковим.
Чому квартилі, розраховані в різних програмах, іноді відрізняються?
У невеликій вибірці позиція, що відповідає 25 % або 75 % результатів, часто знаходиться між двома спостереженнями. Існує кілька математично обґрунтованих способів визначити значення квартиля в такій ситуації: використовувати одне із сусідніх значень, їх середнє або інтерполяцію між ними. Тому різні статистичні програми можуть отримувати дещо різні значення Q1 і Q3. На великих вибірках ці відмінності зазвичай стають незначними.
Дисперсія
Що показує?
Ми вже знаємо мінімальне та максимальне значення, розмах і міжквартильний розмах. Усі вони описують мінливість вибірки по-різному.
Але виникає нове запитання: Наскільки в середньому результати учасників відхиляються від типового значення?
Саме для цього використовують дисперсію.
Дисперсія характеризує ступінь розсіювання результатів відносно середнього значення вибірки. Чим більша дисперсія, тим сильніше результати учасників відрізняються один від одного.
Коли використовують?
Дисперсію використовують:
- як одну з основних характеристик мінливості вибірки;
- для розрахунку стандартного відхилення;
- у багатьох статистичних методах, зокрема дисперсійному аналізі (ANOVA), регресійному аналізі та інших процедурах статистичного аналізу.
Переваги
- враховує відхилення всіх результатів вибірки, а не лише крайніх значень;
- є фундаментом для багатьох статистичних методів (ANOVA, регресія, аналіз надійності тощо);
- дозволяє порівнювати ступінь розсіювання різних груп, якщо результати виміряні в одній шкалі.
Обмеження
Дисперсію можна використовувати для порівняння мінливості різних груп або змінних, якщо вони вимірювалися в одній шкалі. Проте її складніше інтерпретувати безпосередньо, оскільки вона вимірюється в квадратах одиниць вимірювання. Наприклад, якщо тривожність вимірюється в балах, то дисперсія вимірюється вже в балах², що не має самостійного психологічного змісту. Саме тому в психологічних дослідженнях частіше використовують стандартне відхилення, яке має ті самі одиниці вимірювання, що й досліджувана ознака.
Як розраховується?
Ми не можемо просто знайти середнє арифметичне відхилень від середнього, оскільки додатні та від'ємні відхилення взаємно компенсуються і їхня сума завжди дорівнює нулю.
Тому кожне відхилення підносять до квадрата, після чого обчислюють середнє значення цих квадратів відхилень.
\( D = \sigma^{2}=\frac{\sum_{i=1}^n(X_{i}- \bar{X})^{2}}{n-1} \)
Дисперсія є одним з параметрів нормального закону розподілу. Чим більше дисперсія, тим більш пологими є "схили" розподілу і довше його "хвости".
Чим вищою є дисперсія показників вимірюваної властивості (коефіцієнтів регресії, значень змінних тощо), тим менш стійкою вона буде. Висока дисперсія вихідних даних дозволяє припустити високу значущість в них випадкової компоненти, можливу наявність шуму, викидів та аномальних значень.
Приклад: припустимо у нас є вибірка значень {3,4,5,6,7} насамперед розраховуємо вибіркове середнє:
\( \bar{X}=\frac{3+4+5+6+7}{5}=\frac{25}{5}=5 \)
Тепер приступимо до розрахунку дисперсії.
\( D=\frac{(3-5)^{2}+(4-5)^{2}+(5-5)^{2}+(6-5)^{2}+(7-5)^{2}}{5-1} = \frac{4+1+0+1+4}{4} = 2.5 \)
На жаль, не існує ніяких орієнтирів, щоб інтерпретувати величину дисперсії. Тим більше, що на її величину буде впливати розмір шкали вимірювання. Однак, розрахунок дисперсії нам необхідний для визначення наступних статистик.
Стандартне відхилення
Ми вже навчилися оцінювати мінливість за допомогою дисперсії. Але виникає проблема. Дисперсія вимірюється не в балах, сантиметрах чи секундах, а в квадратах цих одиниць. Через це її досить складно інтерпретувати. Саме тому в статистиці набагато частіше використовують стандартне відхилення.
Що показує?
Стандартне відхилення показує, наскільки далеко результати учасників у середньому відхиляються від середнього значення вибірки. Чим більшим є стандартне відхилення, тим більш різнорідною є вибірка і тим сильніше результати окремих учасників відрізняються один від одного. На відміну від дисперсії, стандартне відхилення вимірюється в тих самих одиницях, що й сама досліджувана ознака, тому його значно легше інтерпретувати.
Коли використовують?
- для опису мінливості результатів;
- для порівняння розкиду різних вибірок;
- для побудови нормативних інтервалів;
- для розрахунку довірчих інтервалів і стандартизованих показників;
- як складову багатьох статистичних методів.
Переваги
- враховує всі результати вибірки;
- легко інтерпретується;
- вимірюється в тих самих одиницях, що й досліджувана змінна;
- широко використовується у психологічних дослідженнях.
Обмеження
- чутливе до викидів;
- найкраще працює для розподілів, близьких до нормального;
- саме по собі не показує форму розподілу.
Як розраховується?
\( \sigma=\sqrt{D}=\sqrt{\frac{\sum_{i=1}^n(X_{i}- \bar{X})^{2}}{n-1}} \)
Приклад: розраховувати стандартне відхилення достатню легко після того як розрахували дисперсію. Припустимо у нас є та сама вибірка {3,4,5,6,7}, для неї ми вже розрахували дисперсію і вона дорівнює 2.5, тоді:
\( \sigma=\sqrt{2.5} = 1.58113883 \)
Синоніми:
- середнє квадратичне відхилення
- середньоквадратичне відхилення
- квадратичне відхилення
- стандартний розкид
Приклад.
У двох групах середній рівень тривожності становив 40 балів.
В першій групі SD = 3.
У другій SD = 12.
Це означає, що в першій групі результати учасників дуже схожі між собою, тоді як у другій вони значно сильніше відрізняються.
Стандартне відхилення і нормативні інтервали
Саме стандартне відхилення найчастіше використовують для побудови нормативних інтервалів.
Якщо результати близькі до нормального розподілу, приблизно:
- 68 % спостережень знаходяться в межах ±1 SD;
- 95 % — у межах ±2 SD;
- 99,7 % — у межах ±3 SD.
Саме тому стандартне відхилення широко використовується в психометрії для побудови нормативних шкал. Для цього використовується «правило трьох сигм».
Це правило стверджує, що ймовірність того, що випадкова величина відхилиться від свого математичного очікування більш ніж на три середньоквадратичних відхилення, практично дорівнює нулю. Правило є справедливим тільки для випадкових величин, розподілених за нормальним законом, тому часто використовується в сучасній псіхометриці.
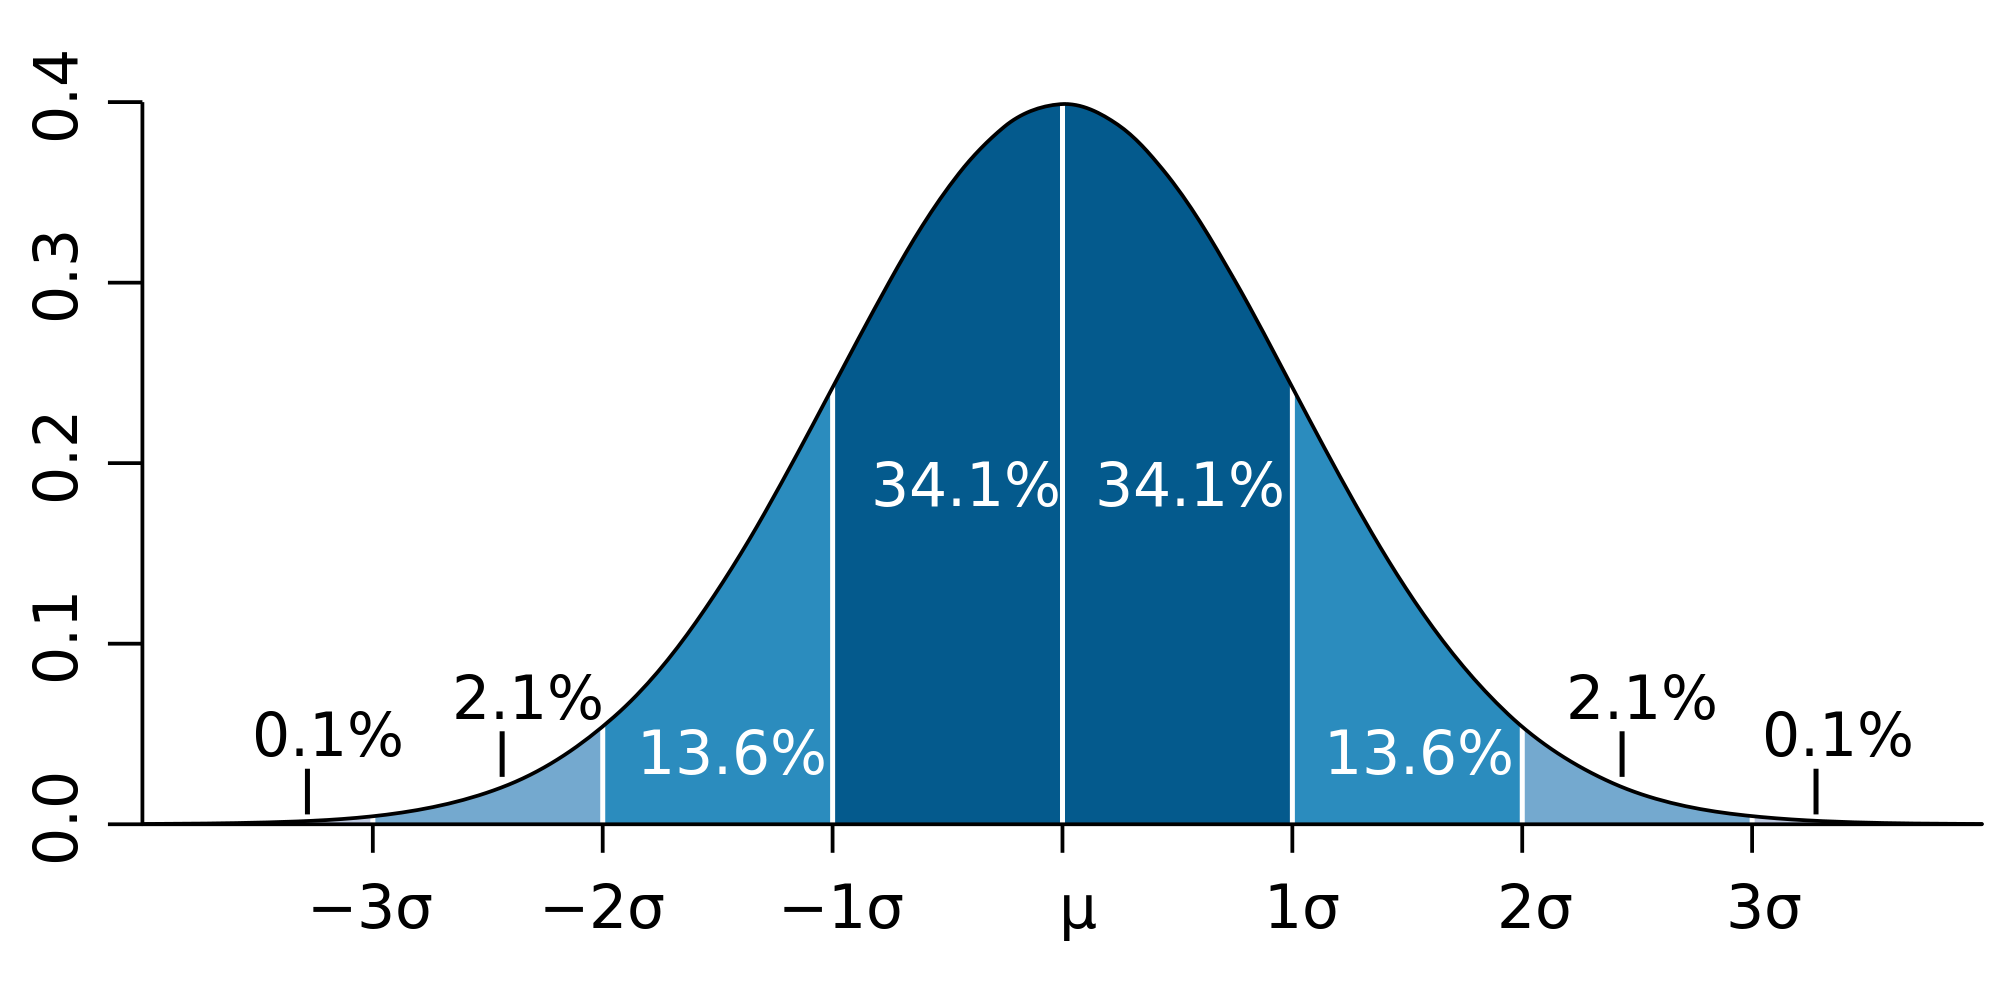
Як показано на малюнку інтервал [-3σ; -1σ] - це значення, які відповідають низькому рівню вираженості властивості, інтервал [-1σ; 1σ] - середньому рівню, а інтервал [1σ; 3σ] - високому.
Приклад:
Ми вимірюємо швидкість мислення за шкалою від 0 до 12. Для застосування правила нам потрібно вирахувати середнє вибіркове і стандартне відхилення.
Припустимо, ми визначили, що середнє М = 7, а стандартне відхилення σ = 1,5.
Далі, як показано на малюнку, нам потрібно тричі відняти стандартне відхилення від середнього (отримаємо: -1σ = 5,5; -2σ = 4, -3σ = 2,5), і тричі додати (1σ = 8,5; 2σ = 10, 3σ = 11,5).
Таким чином отримаємо інтервал низьких значень [2,5; 5,5]; інтервал середніх значень [5,5; 8,5]; інтервал високих значень [8,5; 11,5].
Але це не універсальне правило. Це один із можливих способів побудови нормативних інтервалів. Є методики, де використовують:
- ±0,5 SD;
- ±1 SD;
- квартилі;
- процентили;
- стени;
- стенайни;
- Т-бали.
Коефіцієнт варіації
Що показує?
До цього моменту ми розглянули кілька способів оцінки мінливості вибірки. Проте всі вони залишають відкритим одне важливе запитання: Наскільки великою має бути мінливість, щоб ми сказали: ця вибірка однорідна, а ця — вже неоднорідна?
Саме на це запитання допомагає відповісти коефіцієнт варіації.
Він показує, яку частку від середнього значення становить стандартне відхилення, і виражається у відсотках. Саме завдяки цьому коефіцієнт варіації є однією з небагатьох мір мінливості, для якої існують практичні орієнтири інтерпретації.
Коли використовують?
- коли потрібно оцінити однорідність вибірки;
- коли потрібно порівняти мінливість двох або більше груп із різними середніми;
- коли потрібно оцінити, наскільки стабільно проявляється досліджувана психологічна властивість.
Переваги
- дозволяє порівнювати вибірки з різними середніми;
- має зрозумілі орієнтири для інтерпретації;
- не залежить від одиниць вимірювання;
- виражається у відсотках.
Обмеження
І ось тут є одна дуже важлива річ, яку майже ніхто не пояснює. Коефіцієнт варіації не варто використовувати, якщо середнє значення дуже близьке до нуля або дорівнює нулю. Тоді його значення може бути нестабільним або взагалі не мати змісту. Для більшості психодіагностичних шкал ця проблема майже не виникає, але про неї варто пам'ятати.
Як розраховується?
Коефіцієнт варіації - це величина, що дорівнює відношенню стандартного відхилення випадкової величини до її математичного сподівання (середнього вибіркового). Оскільки коефіцієнт варіації величина відносна, то зазвичай вона виржаеться в процентах.
\( CV = \frac{\sigma}{\bar{X}}\cdot100 \)
У статистиці заведено, що:
- якщо коефіцієнт варіації менше 10%, то ступінь розсіювання даних вважається незначною;
- якщо від 10% до 20% - середньої;
- більше 20% і менше або дорівнює 33% - значною.
Якщо значення коефіцієнта варіації не перевищує 33%, то сукупність вважається однорідною, а якщо більше 33%, то - неоднорідною.
Примітка. Наведені межі є загальноприйнятими практичними орієнтирами для інтерпретації коефіцієнта варіації. У деяких галузях науки можуть використовуватися інші порогові значення.
Припустимо, ми досліджували рівень професійного вигорання у двох групах психологів.
| Група | Середній бал | SD | CV |
|---|---|---|---|
| Практичні психологи | 40 | 4 | 10 % |
| Волонтери кризових центрів | 40 | 12 | 30 % |
Попри однаковий середній рівень вигорання, друга група має значно більшу мінливість результатів. Це означає, що серед волонтерів трапляються як учасники з дуже низьким рівнем вигорання, так і з дуже високим.
Приклад: беремо раніше використовуваний ряд даних {3,4,5,6,7}, для нього у нас пораховано вже і стандартне відхилення і вибіркове середнє, отримаємо:
\( CV = \frac{1.58113883}{5}\cdot100 = 31.6227766 \)
У наведеному прикладі коефіцієнт варіації становить приблизно 31,6 %. Це свідчить про значний ступінь мінливості результатів, однак вибірку ще можна вважати однорідною. Отже, середнє значення досить добре характеризує досліджувану групу, хоча між окремими учасниками вже спостерігаються помітні відмінності.
Підсумок
Міри мінливості не конкурують між собою — кожна з них відповідає на своє дослідницьке запитання.
- Мінімальне та максимальне значення показують межі, в яких знаходяться результати вибірки.
- Розмах характеризує ширину всього діапазону значень.
- Міжквартильний розмах дозволяє оцінити мінливість центральних 50 % результатів і є стійким до впливу викидів.
- Дисперсія характеризує загальний ступінь розсіювання результатів і є основою для багатьох статистичних методів.
- Стандартне відхилення дає змогу оцінити мінливість у тих самих одиницях, що й досліджувана ознака, та широко використовується для побудови нормативних інтервалів.
- Коефіцієнт варіації допомагає оцінити відносну мінливість та зробити висновок про однорідність вибірки.
Саме тому в реальному психологічному дослідженні ці показники не замінюють один одного, а доповнюють. Разом вони дозволяють зрозуміти, наскільки результати учасників відрізняються між собою, чи можна вважати середнє значення типовою характеристикою вибірки та наскільки впевнено можна переходити до подальшого статистичного аналізу.
Після аналізу мір центральної тенденції ми відповіли на запитання: «Яким є типовий результат?»
Після аналізу мір мінливості ми вже можемо відповісти на інше, не менш важливе запитання: «Наскільки цей типовий результат справді типовий для більшості учасників?» Саме поєднання цих двох груп показників дозволяє отримати цілісне уявлення про досліджувану вибірку та переходити до наступного етапу статистичного аналізу.
Якщо після прочитання цієї статті ви відчули, що деякі думки зачепили вас особливо сильно — це нормально. Іноді одна фраза може нагадати про те, що ми довго ховали всередині. Такі моменти — гарний привід зупинитися й прислухатися до себе. І якщо ви відчуваєте, що хочете поговорити, розібратися в собі, отримати підтримку — не відкладайте це надовго. На нашому сайті ви завжди можете звернутися по допомогу до психолога онлайн.